PostgreSQL EXPLAIN과 EXPLAIN ANALYZE 차이: 예상 993행과 실제 1,000행 비교
실행계획 하나 보려다 운영 DB에 부하를 거는 경우
EXPLAIN과 EXPLAIN ANALYZE의 차이는 한 줄로 끝납니다. EXPLAIN은 계획만 세우고, EXPLAIN ANALYZE는 쿼리를 실제로 실행합니다. 운영에서 신경 써야 할 부분은 출력 모양보다 그 “실제로 실행한다”는 쪽입니다. 실행계획 하나 보려다 운영 DB에 부하를 거는 일이 생길 수 있기 때문입니다.
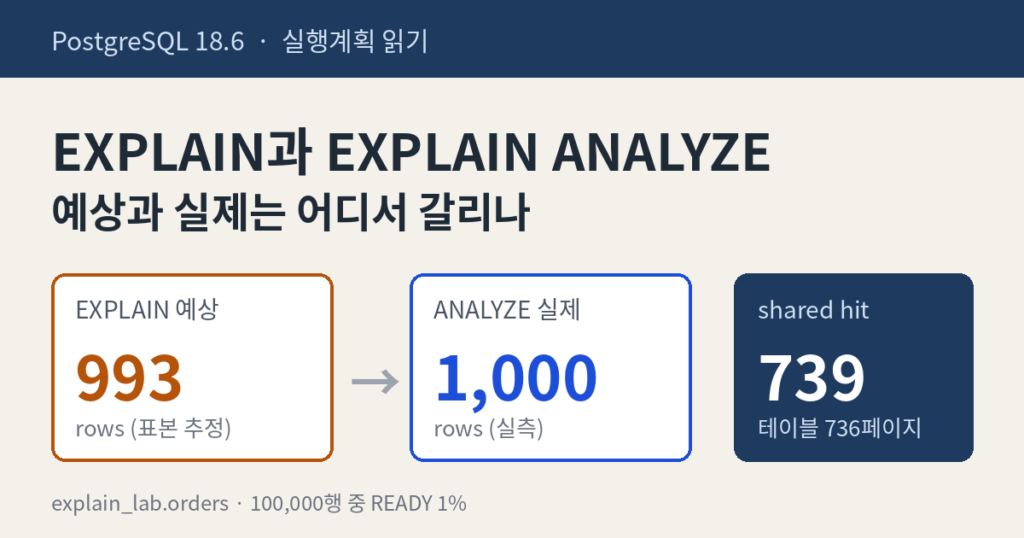
그래서 운영에서는 EXPLAIN ANALYZE를 실행하기 전에 테이블부터 확인합니다. 이번에는 그 확인에 EXPLAIN 단계를 더해 네 단계로 나누고, 테스트 테이블에 그대로 적용했습니다. 예상 993행과 실제 1,000행이 어디서 갈렸는지, 1%의 행을 가져오는 데 왜 버퍼를 739번이나 읽었는지도 같은 순서 안에서 확인했습니다. 테스트 환경은 Windows 로컬의 PostgreSQL 18.6과 DBeaver이고, 운영 환경인 AWS Aurora PostgreSQL과는 별개입니다.
실행계획을 볼 때 밟은 네 단계
- 테이블 확인: 테이블 크기, 건수, 조건절과 조인 조건 컬럼의 인덱스 유무, 파티션 여부
- EXPLAIN: 실행하지 않고 접근 방법과 예상 행 수만 확인
- 실행 판단: 실제로 돌려도 되는지, 돌린다면 어디서 돌릴지 결정
- EXPLAIN ANALYZE: 실제 행 수, 버퍼, 시간을 예상값과 나란히 비교
1단계: 실행계획을 열기 전에 테이블부터 본다
테스트 테이블은 10만 건 중 READY 상태가 1,000건이고, READY는 order_id가 100의 배수인 행이라 테이블 전체에 100행마다 하나씩 흩어져 있습니다. 이 배치가 4단계에서 버퍼 수를 설명하는 근거가 됩니다.
CREATE SCHEMA IF NOT EXISTS explain_lab;

DROP TABLE IF EXISTS explain_lab.orders;

CREATE TABLE explain_lab.orders (
    order_id bigint PRIMARY KEY,
    customer_id integer NOT NULL,
    order_status varchar(10) NOT NULL,
    order_amount integer NOT NULL,
    order_date date NOT NULL
);

INSERT INTO explain_lab.orders (
    order_id, customer_id, order_status, order_amount, order_date
)
SELECT g,
       ((g - 1) % 10000) + 1,
       CASE WHEN g % 100 = 0 THEN 'READY' ELSE 'DONE' END,
       1000 + (g % 100) * 100,
       DATE '2026-01-01' + ((g - 1) % 180)
FROM generate_series(1, 100000) AS s(g);

CREATE INDEX orders_status_idx
    ON explain_lab.orders (order_status);

ANALYZE explain_lab.orders;
스크립트 앞에 DROP TABLE이 있으니 같은 이름의 테이블이 테스트용이 맞는지 보고 실행합니다. 마지막 줄의 ANALYZE는 통계를 모으는 명령으로, 이름이 비슷한 EXPLAIN ANALYZE와는 전혀 다른 일을 합니다.
운영에서 테이블을 확인할 때 보는 항목을 테스트 테이블에도 그대로 조회했습니다. 버전, 건수, 인덱스, 계획에 영향을 주는 설정을 한 번에 묶었습니다.
WITH data_summary AS (
    SELECT count(*) AS total_rows,
           count(*) FILTER (WHERE order_status = 'READY') AS ready_rows,
           count(*) FILTER (WHERE order_status = 'DONE') AS done_rows
    FROM explain_lab.orders
),
capture_items AS (
    SELECT 1 AS sort_no, 'version' AS item, version() AS item_value
    UNION ALL
    SELECT 2, 'database / role', current_database() || ' / ' || current_user
    UNION ALL
    SELECT 3, 'total_rows', total_rows::text FROM data_summary
    UNION ALL
    SELECT 4, 'READY / DONE', ready_rows::text || ' / ' || done_rows::text FROM data_summary
    UNION ALL
    SELECT 5, 'READY percentage',
           round(100.0 * ready_rows / NULLIF(total_rows, 0), 2)::text || '%'
    FROM data_summary
    UNION ALL
    SELECT 6, 'index: ' || indexname, indexdef
    FROM pg_indexes
    WHERE schemaname = 'explain_lab' AND tablename = 'orders'
    UNION ALL
    SELECT 7, 'setting: ' || name, setting || COALESCE(unit, '')
    FROM pg_settings
    WHERE name IN (
        'shared_buffers', 'work_mem', 'random_page_cost',
        'effective_cache_size', 'default_statistics_target',
        'max_parallel_workers_per_gather', 'track_io_timing',
        'enable_seqscan', 'enable_indexscan', 'enable_bitmapscan'
    )
)
SELECT item, item_value
FROM capture_items
ORDER BY sort_no, item;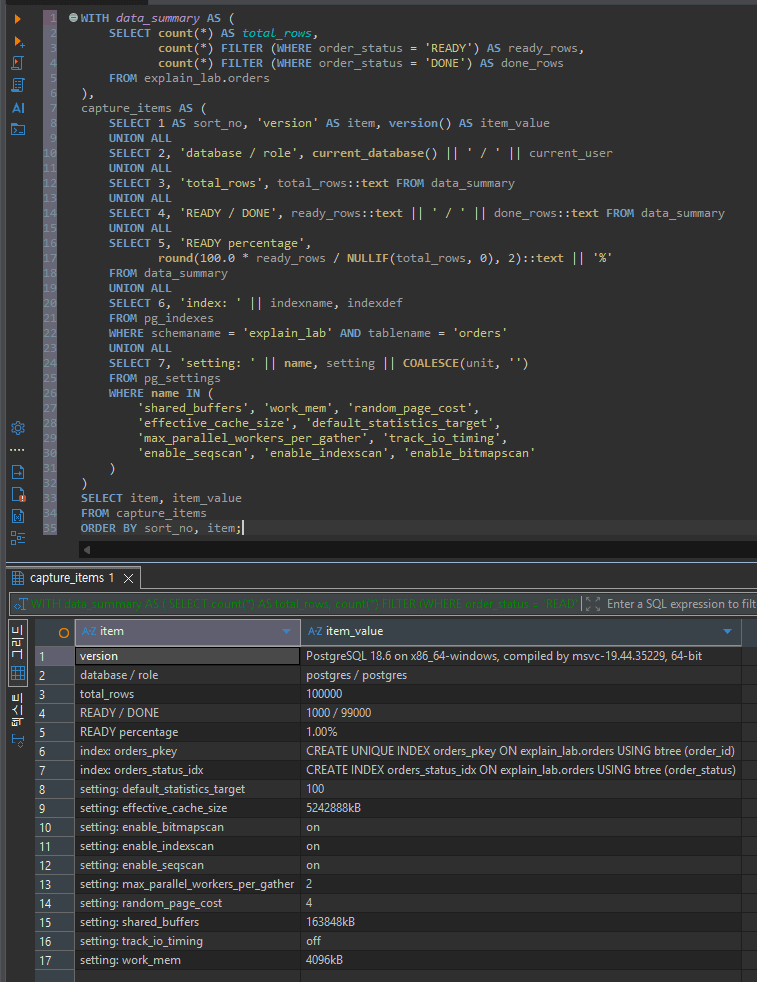
100,000행 중 READY 1,000행, DONE 99,000행입니다. 인덱스는 기본 키 orders_pkey와 조건절 컬럼용 orders_status_idx가 있습니다. 설정은 shared_buffers 128MiB, work_mem 4MiB, effective_cache_size 4GiB, random_page_cost 4, default_statistics_target 100이고, track_io_timing이 off라서 저장장치 읽기 지연은 이번에 볼 수 없습니다.
캡처의 shared_buffers가 163848kB로 보이는 건 16만 kB라는 뜻이 아닙니다. setting 값 16384 뒤에 단위 8kB가 문자열로 붙어 생긴 착시이고, 실제로는 16384 × 8kB = 128MiB입니다. 사람이 읽을 값은 SHOW shared_buffers;로 보는 편이 헷갈리지 않습니다.
건수와 함께 테이블과 인덱스의 크기도 페이지 단위로 확인했습니다. 이 숫자는 4단계에서 버퍼 수와 맞춰 볼 때 다시 씁니다.
SELECT relname, relkind, relpages, reltuples
FROM pg_class
WHERE oid IN (
    'explain_lab.orders'::regclass,
    'explain_lab.orders_status_idx'::regclass
);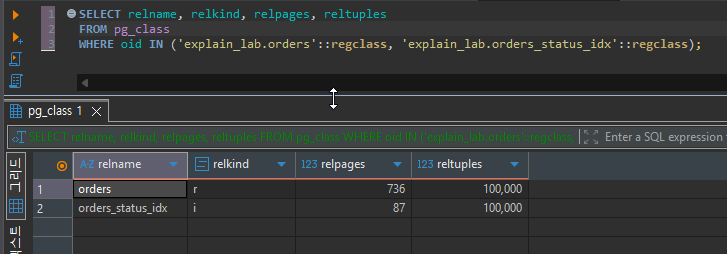
테이블은 736페이지, 인덱스는 87페이지입니다. 100,000행이 736페이지에 들어 있으니 페이지 하나에 약 136행이 들어 있습니다. 데이터를 만들고 건수를 세는 동안 이 블록들이 캐시에 올라왔으므로, 이후 측정은 캐시가 데워진 상태의 값입니다.
2단계: EXPLAIN으로 계획만 본다
EXPLAIN (COSTS ON, BUFFERS OFF, FORMAT TEXT)
SELECT order_id, customer_id, order_status, order_amount, order_date
FROM explain_lab.orders
WHERE order_status = 'READY';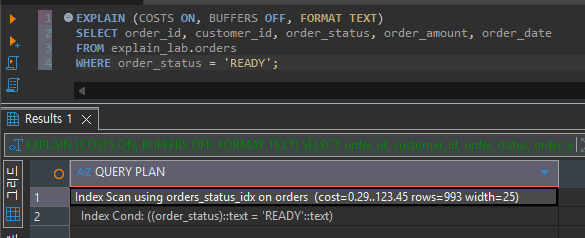
Index Scan using orders_status_idx on orders  (cost=0.29..123.45 rows=993 width=25)
  Index Cond: ((order_status)::text = 'READY'::text)
옵티마이저는 orders_status_idx를 쓰는 Index Scan을 골랐습니다. EXPLAIN은 SELECT를 실행하지 않으므로, 이때 DBeaver 하단에 찍히는 수행 시간은 READY 주문을 읽은 시간이 아니라 계획을 세우고 결과를 받은 시간입니다. Index Cond의 ::text는 order_status가 varchar(10)이라 text 비교 연산자를 쓰면서 붙는 표시이고, 인덱스 사용에는 영향이 없습니다.
cost=0.29..123.45는 밀리초가 아닙니다
앞의 0.29는 첫 행을 내놓기까지의 예상 비용, 뒤의 123.45는 노드가 끝날 때까지의 예상 비용입니다. 단위는 시간이 아니라 페이지 하나를 순서대로 읽는 비용을 1로 둔 상대값입니다. 옵티마이저가 접근 방법을 고를 때 쓰는 점수라서, 123.45를 123ms로 읽거나 다른 서버의 cost와 직접 비교하면 틀립니다. 옆의 width=25는 출력 행 하나의 예상 평균 크기(바이트)입니다.
rows=993은 표본 30,000행에서 나왔습니다
통계를 방금 모았는데 1,000이 아니라 993이 나온 이유는 ANALYZE가 표본을 읽기 때문입니다. 표본 크기는 default_statistics_target 100의 300배인 30,000행으로, 이 테이블에서는 전체의 30%입니다. 표본에서 본 비율은 pg_stats에 남습니다.
SELECT most_common_vals, most_common_freqs, n_distinct
FROM pg_stats
WHERE schemaname = 'explain_lab'
  AND tablename = 'orders'
  AND attname = 'order_status';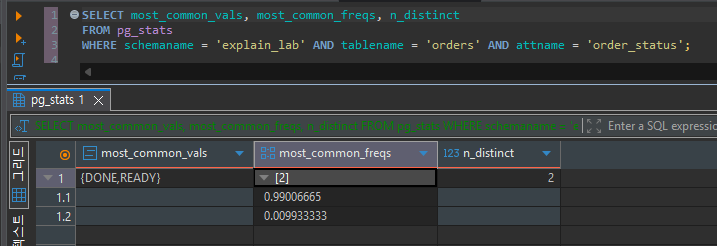
READY 비율은 0.009933333으로 기록돼 있습니다. 옵티마이저는 이 비율에 전체 행 수를 곱하므로 0.009933333 × 100,000 = 993.3, 즉 rows=993입니다. 30,000행 표본으로 거꾸로 계산하면 READY가 298행 잡혔다는 뜻인데, 정확히 1%였다면 300행이어야 합니다. 표본에서 두 행이 덜 뽑힌 것이 예상 7행 차이의 원인입니다. DONE은 0.99006665, n_distinct는 2입니다. ANALYZE를 다시 돌리면 표본이 새로 뽑히므로 993은 다른 값으로 바뀔 수 있습니다.
3단계: 실제로 돌려도 되는지 판단한다
운영에서 EXPLAIN ANALYZE를 실행하기 전에는 테이블 사이즈와 건수, 그리고 조건절과 조인 조건 컬럼에 인덱스가 있는지를 먼저 확인합니다. 이걸 보고 나서 실행하고, 실행 중에 부하가 보이면 그 자리에서 바로 세션을 중단합니다. 서비스에 영향을 줄 수 있다고 판단되면 Aurora의 Reader 인스턴스에서 수행하기도 합니다. EXPLAIN ANALYZE는 SELECT라도 실제로 읽는 만큼 CPU와 I/O를 쓰기 때문입니다.
테스트 쿼리에 같은 기준을 대 보면 이렇습니다.
| 확인 항목 | 테스트 테이블 | 판단 |
|---|---|---|
| 테이블 크기 | 736페이지 (약 5.8MB) | 전체를 읽어도 부담 없음 |
| 건수 | 100,000행 | 작음 |
| 조건절 인덱스 | order_status에 orders_status_idx 있음 | 인덱스 접근 가능 |
| EXPLAIN 예상 | Index Scan, 993행 | 결과 규모가 작음 |
| 결론 | 로컬에서 바로 실행 | |
운영에서 실행 도중 멈춰야 할 때, 실행 중인 화면의 취소 버튼을 쓸 수 없으면 다른 세션에서 pg_stat_activity로 해당 pid를 찾아 pg_cancel_backend(pid)로 쿼리를 취소할 수 있습니다. 취소로 멈추지 않으면 pg_terminate_backend(pid)로 세션 자체를 끊습니다.
INSERT, UPDATE, DELETE에 EXPLAIN ANALYZE를 붙이면 데이터 변경까지 실제로 일어납니다. 변경 SQL의 계획을 볼 때는 테스트 환경에서 트랜잭션을 열고 실행한 뒤 ROLLBACK으로 되돌립니다. DBeaver에서는 자동 커밋을 끄거나 아래처럼 BEGIN을 직접 써서 같은 트랜잭션 안에 넣어야 합니다. Aurora Reader는 읽기 전용이라 변경 SQL의 EXPLAIN ANALYZE는 거기서 실행할 수 없습니다. 아래는 형식 예시이고 실행 결과는 싣지 않았습니다.
BEGIN;

EXPLAIN (ANALYZE, BUFFERS)
UPDATE explain_lab.orders
SET order_status = 'DONE'
WHERE order_status = 'READY';

ROLLBACK;
4단계: EXPLAIN ANALYZE로 예상과 실제를 맞춰 본다
EXPLAIN (ANALYZE, BUFFERS, TIMING ON, SUMMARY ON, FORMAT TEXT)
SELECT order_id, customer_id, order_status, order_amount, order_date
FROM explain_lab.orders
WHERE order_status = 'READY';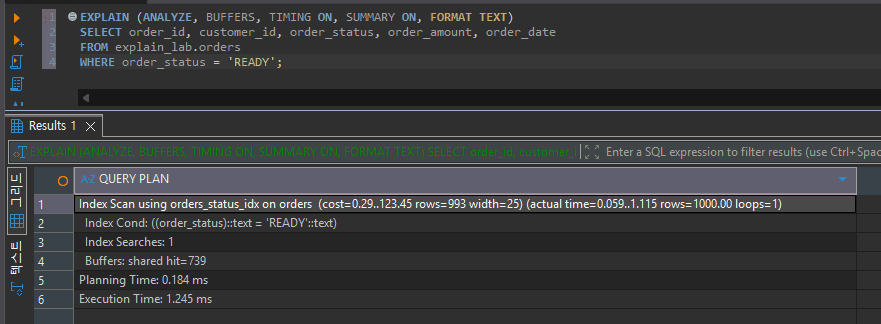
Index Scan using orders_status_idx on orders  (cost=0.29..123.45 rows=993 width=25) (actual time=0.059..1.115 rows=1000.00 loops=1)
  Index Cond: ((order_status)::text = 'READY'::text)
  Index Searches: 1
  Buffers: shared hit=739
Planning Time: 0.184 ms
Execution Time: 1.245 ms
2단계의 EXPLAIN 출력과 나란히 놓으면 첫 번째 괄호는 글자 하나 다르지 않습니다. 추가된 것은 뒤에 붙은 actual 괄호와 그 아래 줄들입니다. 앞 괄호는 실행 전의 추정, actual 괄호는 실제로 실행하며 잰 값입니다.
rows=1000.00 loops=1
actual rows는 이 노드가 실제로 내보낸 행 수이고, loops=1이니 한 번 실행되어 1,000행을 냈습니다. 노드가 여러 번 실행되는 계획에서는 actual rows가 1회당 평균으로 찍히므로 총량은 rows × loops로 다시 계산해야 합니다. 1000.00처럼 소수가 붙는 건 PostgreSQL 18부터 이 평균을 소수 둘째 자리까지 표시하기 때문입니다. 버퍼 정보도 18부터는 BUFFERS를 쓰지 않아도 나오지만, 이전 버전에서도 같은 SQL로 재현할 수 있게 명시했습니다.
실행계획의 1,000이 맞는지 같은 조건으로 건수를 따로 셌습니다.
WITH data_summary AS (
    SELECT count(*) AS total_rows,
           count(*) FILTER (WHERE order_status = 'READY') AS matched_rows,
           count(*) FILTER (WHERE order_status = 'DONE') AS other_rows
    FROM explain_lab.orders
)
SELECT total_rows,
       matched_rows,
       other_rows,
       round(100.0 * matched_rows / NULLIF(total_rows, 0), 2) AS matched_pct,
       1000 AS expected_from_data_generation,
       matched_rows = 1000 AS row_count_matches
FROM data_summary;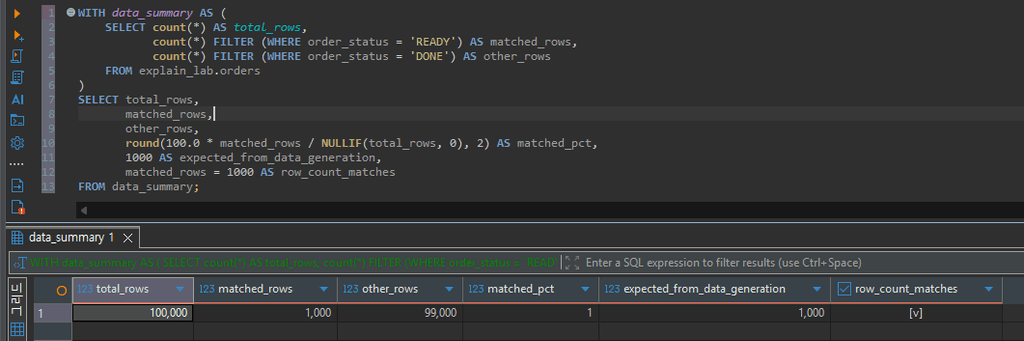
| 어디서 본 값인가 | READY 행 수 |
|---|---|
| EXPLAIN 예상 (pg_stats 0.009933333 × 100,000) | 993 |
| EXPLAIN ANALYZE 실제 출력 | 1,000 |
| COUNT 검증 | 1,000 (row_count_matches true) |
| 예상과 실제의 차이 | 7행, 실제 기준 0.7% |
0.7%는 표본 추정에서 충분히 생길 수 있는 차이라, 통계 수준을 올리거나 인덱스를 손댈 이유가 없습니다. 손을 대야 하는 건 예상과 실제가 몇 배씩 벌어질 때입니다.
Index Searches: 1
PostgreSQL 18부터 나오는 항목으로, 인덱스를 몇 번 내려가 탐색했는지를 보여 줍니다. 이번 조건은 값 하나라 1입니다. IN 목록 조건이나 18의 B-tree skip scan이 쓰이면 이 숫자가 커질 수 있어서, 같은 Index Scan이라도 작업량이 다를 수 있다는 걸 구분해 줍니다.
shared hit=739와 1단계의 736페이지
shared hit는 필요한 블록을 공유 버퍼에서 찾은 횟수입니다. 1,000행에 739번이 많은지는 이 숫자만 봐서는 알 수 없는데, 1단계에서 확인한 테이블 736페이지를 옆에 두면 바로 보입니다.
페이지 하나에 약 136행이 있고 READY는 100행마다 하나씩 있으니, 어느 페이지를 열어도 READY가 한두 개는 들어 있습니다. Index Scan은 READY 1,000건을 따라가면서 결국 테이블 페이지를 모두 한 번씩 방문하게 됩니다. 739에서 736을 빼고 남는 3은 인덱스를 내려가며 읽은 블록으로 보입니다. 인덱스와 테이블 블록을 나눠 집계하지는 않았습니다.
전체의 1%만 가져왔는데 테이블 기준으로는 Seq Scan이 읽을 736페이지와 거의 같은 양을 지나간 셈입니다. 인덱스를 탔다는 것과 적게 읽었다는 것은 별개입니다. 이번엔 1.245ms로 끝났지만, 테이블이 수천만 행이고 캐시에 없었다면 이 차이가 그대로 디스크 읽기로 바뀝니다. 같은 1,000행이 한 구간에 모여 있었다면 방문할 테이블 페이지는 1,000 ÷ 136, 여덟 페이지 안팎이었을 겁니다. 이 숫자는 계산값이고 측정하지는 않았습니다.
출력에 shared read가 없는 것은 공유 버퍼 밖에서 가져온 블록이 0이었다는 뜻입니다. 운영체제 캐시까지 포함해 디스크 I/O가 전혀 없었다는 의미는 아닙니다.
Planning 0.184 ms, Execution 1.245 ms
노드의 actual time=0.059..1.115는 첫 행까지 0.059ms, 노드 종료까지 1.115ms입니다. Execution Time 1.245ms는 실행기 시작과 종료까지 포함해 노드 시간보다 조금 길고, Planning Time 0.184ms는 계획을 세운 시간으로 따로 셉니다. EXPLAIN ANALYZE는 결과 행을 클라이언트로 보내지 않으므로 네트워크 전송과 화면 표시 시간은 들어 있지 않습니다. PostgreSQL 17부터는 SERIALIZE 옵션으로 출력 변환 비용을 따로 잴 수 있지만 이번엔 쓰지 않았습니다.
이 시간은 한 번 실행한 값입니다. 1ms 안팎의 쿼리는 로컬 PC의 CPU 스케줄링이나 TIMING ON의 계측 오버헤드만으로도 실행할 때마다 흔들리므로, 1.245ms를 이 쿼리의 응답 시간으로 정해 두지는 않았습니다. 시간을 비교하려면 같은 조건에서 여러 번 돌려 분포를 봐야 하고, 계측 오버헤드가 신경 쓰이면 TIMING OFF로 노드별 시간을 끄고 행 수와 버퍼만 비교하는 방법도 있습니다.
예상과 실제가 크게 어긋났을 때 먼저 의심할 것
이번처럼 예상과 실제가 비슷하면 버퍼와 접근 방법이 목적에 맞는지만 보면 됩니다. 차이가 크게 벌어진 계획이라면 아래 노드부터 위로 올라가며 어디서 오차가 시작되는지 찾습니다. 집계 쿼리는 최상위 노드가 1행만 내보내도 그 아래에서는 수십만 행을 처리했을 수 있으니, rows는 그 노드가 내보낸 행 수로만 읽습니다.
| 실행계획에서 본 것 | 먼저 의심할 것 |
|---|---|
| 실제가 예상보다 훨씬 많음 | 통계 갱신 시점, 값 편중, 조건 컬럼 사이의 상관관계 |
| 실제가 예상보다 훨씬 적음 | 대량 삭제 뒤 통계 미갱신, 조건에 들어간 함수나 형변환 |
| loops가 큼 | rows × loops로 총량을 다시 계산하고 바깥쪽 노드의 추정 확인 |
| Index Scan인데 버퍼가 많음 | 대상 행이 테이블에 흩어진 정도 (이번 테스트의 739) |

댓글 0
첫 댓글을 남겨보세요.