PostgreSQL 18 테스트 환경과 10만 건 기준 테이블: 건수·통계·실행계획 기준값 만들기
인덱스를 하나 추가했을 때 달라진 숫자는 무엇 때문인가
인덱스를 추가하거나 통계를 바꾼 뒤 숫자가 달라졌다면, 그 차이가 변경 때문인지 데이터나 환경이 달라서인지부터 가려야 합니다. 그러려면 PostgreSQL 테스트가 모두 같은 테이블, 같은 데이터에서 출발해야 합니다. 그 출발점으로 dba_lab.baseline_orders 테이블을 만들고, 이후 테스트에서 그대로 비교할 기준값을 확인했습니다.
기준값을 먼저 표로 두고, 각 값이 어떤 SQL과 조회 결과에서 나왔는지는 아래에서 차례로 설명합니다. 테스트는 Windows 로컬에 설치한 PostgreSQL 18.6에 DBeaver로 접속해 자동 커밋 상태에서 진행했습니다. 운영 환경인 AWS Aurora PostgreSQL과는 별개의 로컬 환경입니다.
baseline_orders 기준값 카드
| 항목 | 기준값 | 확인한 곳 |
|---|---|---|
| 버전 | PostgreSQL 18.6 (Windows, 64-bit) | version() |
| 접속 위치 | DB postgres, 사용자 postgres, 기본 스키마 public | current_database(), current_schema() |
| 대상 테이블 | dba_lab.baseline_orders (스키마를 항상 붙여서 사용) | information_schema.tables |
| 행 수 | 100,000건 | count(*) |
| 테이블 크기 | 834페이지 (페이지당 약 120행) | EXPLAIN ANALYZE의 shared hit |
| 주문 상태 | completed 70,000 · processing 20,000 · pending 10,000 | GROUP BY order_status |
| 인덱스 | baseline_orders_pkey 하나 (order_id) | pg_indexes |
| 통계 | 입력 직후 수동 ANALYZE, 표본 30,000행 | pg_stat_user_tables, pg_stats |
| 알고 써야 할 상관관계 | 고객·날짜가 상태를 결정, amount = order_id ÷ 100 | 생성 규칙 계산, 섞인 고객 0명 |
스키마 이름 pg_dba_lab이 거부된 이유
처음에는 스키마 이름을 pg_dba_lab으로 정했는데, CREATE SCHEMA 단계에서 바로 막혔습니다.
SQL Error [42939]
unacceptable schema name "pg_dba_lab"
The prefix "pg_" is reserved for system schemas.
PostgreSQL은 pg_catalog, pg_toast처럼 시스템 스키마에 pg_ 접두사를 쓰기 때문에, 사용자가 pg_로 시작하는 스키마를 만들 수 없게 해 둡니다. 42939는 예약된 이름(reserved_name)을 썼다는 오류 코드입니다.
권한 문제가 아니라서 슈퍼유저인 postgres로 접속해 있어도 결과는 같습니다. 설정을 바꿀 방법을 찾을 필요 없이 이름을 dba_lab으로 바꾸면 끝납니다. 역할(role) 이름도 마찬가지로, pg_read_all_data 같은 기본 제공 역할과 겹치지 않도록 pg_로 시작하는 이름은 만들 수 없습니다.
객체가 public에 만들어졌던 일과 접속 위치 확인
Aurora PostgreSQL 운영 환경에서 객체를 만들었는데, 의도한 스키마가 아니라 public에 생성된 적이 있습니다. 작업을 마치고 다시 접속해서 그 객체를 조회하니 없다는 메시지가 나와 꽤 당황했습니다. 스키마를 지정하지 않은 CREATE 문은 search_path의 첫 번째 유효한 스키마에 객체를 만들기 때문에 생긴 일이었습니다.
비슷한 일이 데이터베이스 단위에서도 있었습니다. 다른 데이터베이스에 접속한 상태로 테이블을 조회했다가 테이블이 없다는 메시지를 받았고, 접속 데이터베이스를 바꾸고 나서야 정상적으로 조회됐습니다. 한 세션은 접속한 데이터베이스 하나만 보고, dblink나 postgres_fdw를 쓰지 않는 한 다른 데이터베이스의 테이블을 이름으로 참조할 수 없습니다. 그 뒤로는 쿼리를 실행하기 전에 지금 어디에 붙어 있는지부터 확인하고, 이번 테스트도 같은 순서로 시작했습니다.
SELECT
    current_database() AS database_name,
    current_user AS user_name,
    current_schema() AS current_schema,
    version() AS postgresql_version;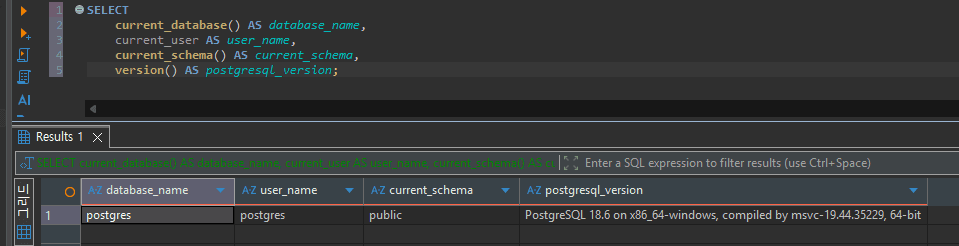
데이터베이스와 사용자는 postgres, 버전은 PostgreSQL 18.6 on x86_64-windows(msvc-19.44.35229, 64-bit)입니다. 현재 스키마가 dba_lab이 아니라 public으로 나온 것은 정상입니다. 기본 search_path는 "$user", public이고, postgres라는 이름의 스키마가 없으니 다음 순서인 public이 잡힙니다.
운영에서 객체가 public에 생긴 것도 바로 이 구조 때문입니다. 그래서 이번 테스트와 이후 테스트의 SQL은 전부 dba_lab.baseline_orders처럼 스키마 이름을 붙여 씁니다. 같은 이름의 테이블이 다른 스키마에도 있는지는 아래 쿼리로 확인할 수 있습니다. 두 번째 결과에 dba_lab 외의 스키마가 함께 나오면, 스키마를 생략한 SQL은 search_path 순서에 따라 다른 테이블을 읽습니다.
SHOW search_path;

SELECT table_schema, table_name
FROM information_schema.tables
WHERE table_name = 'baseline_orders'
ORDER BY table_schema;
테이블 정의와 매번 같은 값이 나오는 생성 규칙
CREATE SCHEMA IF NOT EXISTS dba_lab;

CREATE TABLE IF NOT EXISTS dba_lab.baseline_orders
(
    order_id     bigint PRIMARY KEY,
    customer_id  integer NOT NULL,
    order_status text NOT NULL
        CHECK (order_status IN ('pending', 'processing', 'completed')),
    amount       numeric(10, 2) NOT NULL,
    created_at   timestamptz NOT NULL
);
CREATE TABLE IF NOT EXISTS는 같은 이름의 테이블이 이미 있으면 생성을 건너뛰기만 합니다. 기존 테이블의 컬럼이나 제약 조건을 지금 정의에 맞게 고쳐 주지 않으니, 예전에 만든 테이블이 남아 있었다면 아래 구조 확인 쿼리를 꼭 다시 봐야 합니다.
데이터는 실행할 때마다 똑같이 나와야 다른 글과 비교할 수 있습니다. 그래서 random()이나 now() 없이 모든 값을 주문 ID 하나에서 계산했습니다.
INSERT INTO dba_lab.baseline_orders
    (order_id, customer_id, order_status, amount, created_at)
SELECT
    g AS order_id,
    ((g - 1) % 10000 + 1)::integer AS customer_id,
    CASE
        WHEN g % 10 = 0 THEN 'pending'
        WHEN g % 10 IN (1, 2) THEN 'processing'
        ELSE 'completed'
    END AS order_status,
    ((g % 500000)::numeric / 100)::numeric(10, 2) AS amount,
    timestamptz '2026-01-01 00:00:00+00'
        - ((g % 90) * interval '1 day') AS created_at
FROM generate_series(1, 100000) AS g
ON CONFLICT (order_id) DO NOTHING;

ANALYZE dba_lab.baseline_orders;| 컬럼 | 생성 규칙 | 결과 범위 |
|---|---|---|
| order_id | generate_series 값 g | 1 ~ 100,000 |
| customer_id | (g − 1) % 10000 + 1 | 1 ~ 10,000 반복, 고객당 10건 |
| order_status | g의 일의 자리 | 0 → pending, 1·2 → processing, 3~9 → completed |
| amount | g % 500000 / 100 | 0.01 ~ 1,000.00 |
| created_at | 2026-01-01 00:00 UTC − (g % 90)일 | 2025-10-04 ~ 2026-01-01, 90개 날짜 |
다른 환경에서 똑같이 만들 때 걸릴 수 있는 부분은 세 가지입니다.
- 주문 시각은 UTC 고정 시각에서 계산합니다. DBeaver 세션 시간대가 Asia/Seoul이면 화면에 09:00으로 보일 뿐, 저장된 값은 같습니다.
- timestamptz에서
interval '1 day'를 빼는 계산은 세션 시간대의 달력을 따릅니다. 서머타임이 있는 시간대로 접속하면 경계 날짜에서 1시간이 어긋날 수 있으니, 세션 시간대도 함께 기록해 둡니다. ON CONFLICT (order_id) DO NOTHING덕분에 INSERT를 다시 실행해도 행이 늘지 않습니다. 대신 이미 바뀐 값을 되돌리지도 않으므로, 처음 상태가 필요하면TRUNCATE후 다시 넣습니다.
ANALYZE는 입력 직후 직접 실행했습니다. autovacuum도 통계를 갱신하지만 언제 돌지 알 수 없어서, 통계 기준 시점을 직접 정해 두려는 것입니다. 수동 실행 시각은 last_analyze, 자동 실행 시각은 last_autoanalyze에 남습니다.
SELECT relname, n_live_tup, last_analyze, last_autoanalyze
FROM pg_stat_user_tables
WHERE schemaname = 'dba_lab'
  AND relname = 'baseline_orders';
건수, 컬럼, 인덱스가 정의대로 들어갔는지
상태별 건수와 주문 ID 범위
INSERT에 100,000건을 지정했어도, 이전 실행의 행이 남아 있었다면 ON CONFLICT가 일부를 건너뛰었을 수 있습니다. 결과는 조회로 확인했습니다.
SELECT
    order_status,
    count(*) AS row_count,
    round(count(*) * 100.0 / sum(count(*)) OVER (), 2) AS percent,
    min(order_id) AS min_order_id,
    max(order_id) AS max_order_id
FROM dba_lab.baseline_orders
GROUP BY order_status
ORDER BY order_status;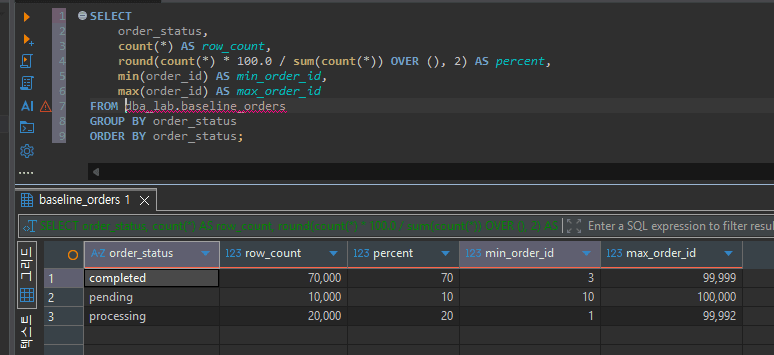
| 주문 상태 | 행 수 | 비율 | 최소 order_id | 최대 order_id |
|---|---|---|---|---|
| completed | 70,000 | 70% | 3 | 99,999 |
| pending | 10,000 | 10% | 10 | 100,000 |
| processing | 20,000 | 20% | 1 | 99,992 |
최소·최대 주문 ID도 규칙과 맞습니다. processing은 일의 자리가 1·2인 ID라 1에서 시작해 99,992에서 끝나고, pending은 10부터 100,000까지입니다. 세 상태 모두 1~100,000 전 구간에 걸쳐 있으니, 상태별 행이 테이블 전체에 고르게 섞여 저장돼 있습니다.
컬럼 정의
SELECT table_schema, table_name, ordinal_position,
       column_name, data_type, is_nullable
FROM information_schema.columns
WHERE table_schema = 'dba_lab'
  AND table_name = 'baseline_orders'
ORDER BY ordinal_position;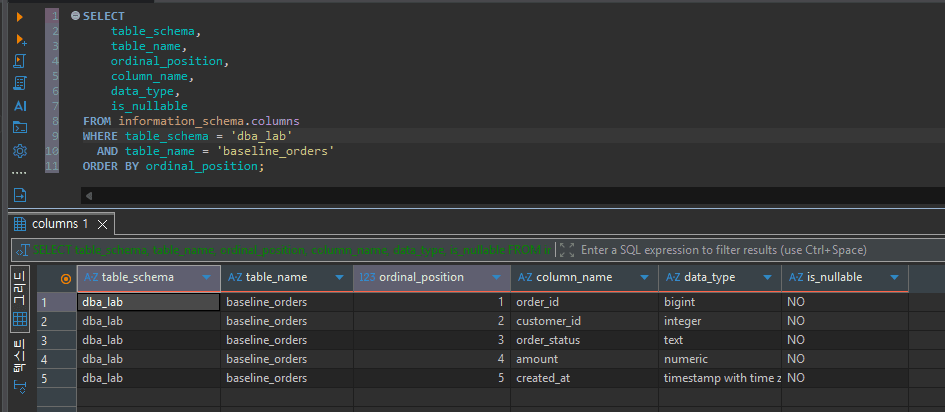
다섯 컬럼 모두 is_nullable이 NO입니다. order_id는 기본키라서, 나머지는 NOT NULL을 지정해서입니다. amount가 numeric으로만 보이는 건 data_type 컬럼에 정밀도가 나오지 않기 때문이고, numeric(10, 2)까지 보려면 같은 뷰의 numeric_precision, numeric_scale을 함께 조회하면 됩니다. 이번 캡처에는 넣지 않았습니다.
인덱스 구성
SELECT schemaname, tablename, indexname, indexdef
FROM pg_indexes
WHERE schemaname = 'dba_lab'
  AND tablename = 'baseline_orders'
ORDER BY indexname;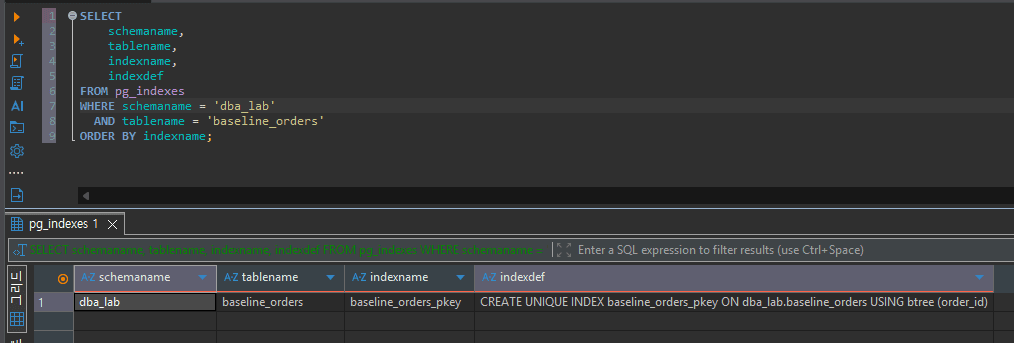
인덱스는 CREATE UNIQUE INDEX baseline_orders_pkey ON dba_lab.baseline_orders USING btree (order_id) 하나뿐입니다. 기본키를 지정하면 PostgreSQL이 테이블명_pkey 이름으로 자동 생성하는 인덱스입니다. customer_id, order_status, created_at에는 인덱스가 없고, 이후 인덱스 관련 글은 모두 이 상태에서 시작합니다.
플래너가 보는 값은 표본 30,000행에서 나옵니다
count(*)는 실제 행을 세지만, 실행계획을 고르는 플래너는 ANALYZE가 만든 통계를 봅니다. ANALYZE는 테이블 전체가 아니라 표본을 읽고, 표본 크기는 default_statistics_target 기본값 100의 300배인 30,000행입니다. 100,000건 중 30%만 보고 만든 값이라는 뜻입니다.
SELECT attname, n_distinct, most_common_vals, most_common_freqs, correlation
FROM pg_stats
WHERE schemaname = 'dba_lab'
  AND tablename = 'baseline_orders'
ORDER BY attname;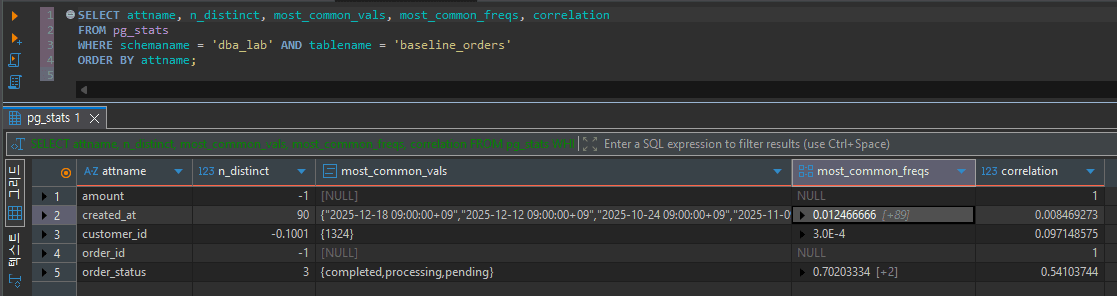
| 컬럼 | n_distinct | most_common_vals / freqs | correlation | 실제 데이터 |
|---|---|---|---|---|
| amount | -1 | 없음 | 1 | 모든 값 고유, order_id ÷ 100 |
| created_at | 90 | 90개 날짜 모두, 최고 0.012466666 | 0.008469273 | 날짜당 1/90 ≈ 0.0111 |
| customer_id | -0.1001 | {1324} / 3.0E-4 | 0.097148575 | 10,000명, 고객당 10건(0.0001) |
| order_id | -1 | 없음 | 1 | 모든 값 고유 |
| order_status | 3 | completed 0.70203334 외 2개 | 0.54103744 | 0.7 · 0.2 · 0.1 |
order_id와 amount의 correlation이 1인 것은 예상대로입니다. 두 값 모두 입력 순서대로 커지고, 행도 그 순서로 저장됐습니다. created_at은 90행마다 날짜가 처음으로 돌아가니 0.0085로 사실상 0입니다.
눈여겨볼 값은 customer_id입니다. n_distinct -0.1001은 전체 행의 10.01%, 약 10,010명으로 추정했다는 뜻이라 실제 10,000명과 거의 같습니다. 그런데 최빈값 목록에 고객 1324 한 명이 3.0E-4로 올라 있습니다. 30,000행 표본에 이 고객이 9번 들어갔다는 계산이 나옵니다. 실제로는 모든 고객이 정확히 10건씩이니, 표본이 우연히 이 고객을 많이 뽑은 것입니다. 이 통계를 그대로 쓰면 플래너는 고객 1324의 주문을 30건 정도로, 다른 고객은 10건 정도로 보게 됩니다. 통계값으로 계산한 숫자이고, 실행계획으로 확인하지는 않았습니다. ANALYZE를 다시 돌리면 표본이 바뀌므로 이 값도 달라질 수 있습니다.
order_status의 correlation 0.54도 처음엔 이상해 보입니다. 세 상태가 10행 주기로 고르게 섞여 있으니 0에 가까울 것 같기 때문입니다. ANALYZE는 표본을 값 순서로 정렬할 때 같은 값끼리는 물리 위치 순서로 줄을 세웁니다. 값 종류가 셋뿐이면 같은 값 안의 순서가 물리 순서와 그대로 맞물려 correlation이 높게 잡히는 것으로 보입니다. 이 계산 과정을 직접 확인하지는 않았습니다. 고유값이 적은 컬럼의 correlation은 고유값이 많은 컬럼과 같은 무게로 읽으면 안 됩니다. completed 비율 0.702가 실제 0.7과 소수 셋째 자리에서 다른 것도 표본 통계에서 생기는 정도의 오차입니다.
생성 규칙 안에 숨어 있는 세 가지 상관관계
규칙으로 만든 데이터는 재현하기 쉬운 대신, 컬럼 사이에 의도하지 않은 강한 관계가 생깁니다. 생성 SQL을 따라 계산해 보면 세 가지가 나옵니다.
- 고객이 상태를 정합니다. 고객 ID는 g를 10,000으로 나눈 나머지에서 나오고 10,000은 10의 배수입니다. 그래서 고객 ID의 일의 자리가 곧 g의 일의 자리이고, 한 고객의 10건은 모두 같은 상태입니다. pending 고객 1,000명, processing 2,000명, completed 7,000명입니다.
- 날짜도 상태를 정합니다. 90 역시 10의 배수라, 90개 날짜 중 9일은 pending만, 18일은 processing만, 63일은 completed만 있습니다.
- 금액은 주문 ID와 같은 순서입니다. g가 최대 100,000이므로
g % 500000은 g 그대로이고, amount는 정확히 order_id ÷ 100입니다. pg_stats의 correlation 1이 이를 보여 줍니다.
첫 번째 관계는 상태가 두 개 이상 섞인 고객 수를 세어 보면 바로 확인됩니다.
SELECT count(*) AS mixed_status_customers
FROM (SELECT customer_id
      FROM dba_lab.baseline_orders
      GROUP BY customer_id
      HAVING count(DISTINCT order_status) > 1) AS t;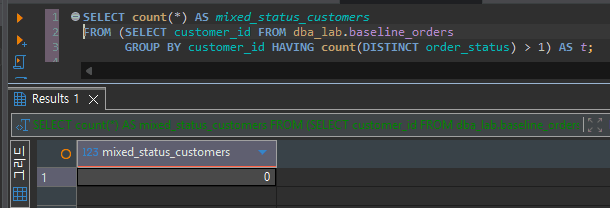
결과는 0명입니다. 10,000명 모두 한 가지 상태만 가지고 있습니다.
실제 10행을 1행으로 본 실행계획
PostgreSQL 플래너는 기본적으로 WHERE 조건의 컬럼들이 서로 독립이라고 보고 선택도를 곱합니다. 위의 상관관계를 모르는 상태에서 어떤 값을 내는지 보려고, 주문 10건이 모두 pending인 고객 10으로 두 조건을 같이 걸었습니다.
EXPLAIN ANALYZE
SELECT *
FROM dba_lab.baseline_orders
WHERE order_status = 'pending'
  AND customer_id = 10;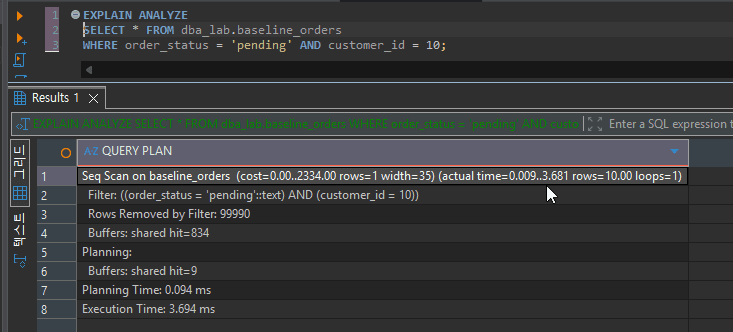
Seq Scan on baseline_orders  (cost=0.00..2334.00 rows=1 width=35) (actual time=0.009..3.681 rows=10.00 loops=1)
  Filter: ((order_status = 'pending'::text) AND (customer_id = 10))
  Rows Removed by Filter: 99990
  Buffers: shared hit=834
Planning:
  Buffers: shared hit=9
Planning Time: 0.094 ms
Execution Time: 3.694 ms
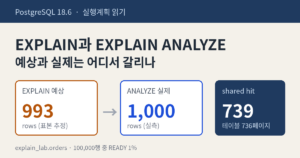
예상 1행, 실제 10행입니다. 상태 선택도 약 10%와 고객 선택도 약 1/10,000을 곱하면 100,000 × 0.1 × 0.0001 = 1행이 나오니, 독립 가정을 그대로 따른 계산입니다. 실제로는 고객 10의 주문이 전부 pending이라 두 조건은 사실상 하나였습니다.
같은 실행계획에서 기준값으로 남겨 둘 숫자도 있습니다.
- customer_id에 인덱스가 없어 Seq Scan으로 100,000행을 모두 읽고 99,990행을 버렸습니다.
shared hit=834는 테이블 전체가 834페이지라는 뜻이고, 페이지당 약 120행입니다.- 비용 2334.00은 기본 비용 상수로 다시 계산해도 정확히 맞습니다. 834페이지 × seq_page_cost 1.0에, 100,000행 × (cpu_tuple_cost 0.01 + 조건 두 개 × cpu_operator_cost 0.0025)를 더하면 834 + 1,500 = 2,334입니다.
- PostgreSQL 18은 EXPLAIN ANALYZE에 BUFFERS를 지정하지 않아도 버퍼 정보를 보여 주고, 실제 행 수를
rows=10.00처럼 소수 둘째 자리까지 표시합니다. 이전 버전의 실행계획과 비교할 때 참고하세요.
이 쿼리처럼 단일 테이블을 Seq Scan으로 읽을 때는 1행과 10행의 차이가 결과에 영향을 주지 않습니다. 하지만 조인 순서나 조인 방식을 골라야 하는 쿼리라면 이런 과소 추정이 계획 자체를 바꿀 수 있습니다. 상태와 맞지 않는 조합(예: pending과 고객 11)은 실제로 0건이지만 추정은 비슷하게 나올 것으로 보는데, 이 경우는 이번에 실행하지 않았습니다.
이 테이블에 맡길 검증과 맡기지 않을 검증
| 이 테이블로 확인할 것 | 이 테이블로는 확인하지 않을 것 |
|---|---|
| 단일 컬럼 조건에서 인덱스 유무에 따른 차이 | 실제 서비스 수준의 인덱스 범위 검색 비용 (amount가 물리 순서와 완전히 일치) |
| 행 수 변화와 통계 갱신 전후 비교 | 상태·고객, 상태·날짜 조합 선택도를 일반적인 결과로 해석하는 일 |
다중 컬럼 통계(CREATE STATISTICS) 효과 — 위 상관관계를 일부러 활용 | 값이 한쪽으로 치우친 분포(소수 고객에 주문 집중)가 필요한 주제 |
실제와 비슷한 분포가 필요한 주제는 데이터를 따로 만들고, 그 생성 규칙과 분포를 함께 공개하겠습니다.
다음 테스트를 시작하기 전에 돌릴 기준값 확인 SQL
이후 테스트에서는 본문에 들어가기 전에 아래 쿼리 하나로 접속 위치와 테이블 상태를 확인하고 결과를 같이 남기겠습니다. 위 기준값 카드와 다르게 나오면 결과 숫자를 비교하기 전에 그 차이부터 정리합니다.
SELECT
    current_database() AS database_name,
    current_schema() AS current_schema,
    (SELECT count(*) FROM dba_lab.baseline_orders) AS row_count,
    pg_relation_size('dba_lab.baseline_orders')
        / current_setting('block_size')::int AS table_pages,
    (SELECT count(*) FROM pg_indexes
      WHERE schemaname = 'dba_lab'
        AND tablename = 'baseline_orders') AS index_count,
    (SELECT last_analyze FROM pg_stat_user_tables
      WHERE schemaname = 'dba_lab'
        AND relname = 'baseline_orders') AS last_analyze;
지금 기준으로는 row_count 100,000, index_count 1이 나와야 합니다. table_pages는 실행계획에서 본 834페이지와 같은 크기를 가리킵니다. UPDATE를 거치면 새 행 버전이 쌓이면서 이 값이 늘어날 수 있고, DELETE 후에는 row_count가 줄어도 table_pages는 그대로 남을 수 있습니다. 두 값이 따로 움직이기 시작하면 테이블 안에 죽은 행 버전이나 빈 공간이 생겼다는 신호로 보고 따로 확인합니다.

댓글 0
첫 댓글을 남겨보세요.